RAG (Retrieval-Augmented Generation) me LLM ke jawab dene se pehle documents me se sawaal se juda hissa dhoondh ke uske saath bheja jaata hai. Phir LLM usi hisse ko padh ke jawab deta hai.
Naam ka matlab: Retrieval (dhoondo) + Augmented (prompt me jodo) + Generation (LLM jawab likhe)
Example: Open-book exam 📖
Bina RAG: LLM ka closed-book exam. Jo yaad hai wahi likhega, nahi pata to bhi kuch bana dega (hallucination).
RAG ke saath: Open-book exam. Pehle book me sahi page dhoondo, phir padh ke likho.
Kyun chahiye:
Problem | RAG kaise solve karta hai |
|---|---|
LLM ne tumhare documents kabhi padhe hi nahi (company files, notes, nayi info) | Document ka relevant hissa prompt me daal dete hain |
Poora document prompt me nahi aata (context limit) | Sirf 3-5 relevant tukde bhejte hain |
LLM galat bana deta hai | "Sirf context se jawab do, nahi pata to 'I don't know' bolo" |
Jawab kahan se aaya? | Source + page number dikha sakte hain |
Kahan use hota hai: "Chat with PDF", company ka internal help-bot, customer support bot, legal/medical documents me search.
Chunk kya hota hai?
Bade text ka chhota tukda. Jaise 100 page ki kitaab ko chhote-chhote paragraphs me kaat dena.
Kyun? Sawaal ka jawab poore document me nahi, kisi ek paragraph me hota hai. Poore document ka ek vector banaoge to sab topics mix ho jaayenge. Chhote tukde = ek tukda, ek topic.
Example (size = 80 characters, overlap = 20):
Chunk 0: 'Conda is a package manager. It creates isolated environments. Each environment h'
Chunk 1: '. Each environment has its own Python version and libraries. This prevents confl'
Overlap: "Each environment" dono chunks me hai, taaki koi baat beech me se kat ke kho na jaaye.
Size ka trade-off: Bahut chhota (100 characters) → context adhoora. Bahut bada (5000) → topics mix, search kamzor. Aam taur pe 500-1000 characters aur 10-20% overlap rakhte hain.
Chunk karne ke tareeke: fixed size (characters/tokens), sentence ya paragraph ke hisaab se, ya headings ke hisaab se.
Vector (embedding) kya hota hai?
Numbers ki list jo text ka "matlab" batati hai.
Text ko vector me badalne ko embedding kehte hain, aur ye kaam ek embedding model karta hai.
Samajhne ke liye maan lo sirf 2 number hain: [sports, khaana]
"Virat ne century maari"   → [0.9, 0.1]   ┐ dono sports wale,
"Dhoni ne six maara"       → [0.8, 0.1]   ┘ numbers paas-paas
"Biryani bahut tasty hai"  → [0.1, 0.9]     khaane wala, door
Jinka matlab milta hai, unke numbers paas-paas hote hain. Isi se computer "matlab" compare karta hai.
Example: Map Har shahar ka (latitude, longitude) hota hai. Paas wale shahar → paas wale numbers. Embedding me har text ka sainkdon numbers ka "address" hota hai.
Asli embedding models 384 se 3000+ numbers banate hain (jaise 768). Un numbers ke naam (sports, khaana) nahi hote, model training me khud seekhta hai. Akele number ka koi matlab nahi, poori list milke matlab batati hai.
Embedding model ≠ chat LLM. Embedding model sirf text ko numbers banata hai, jawab nahi likhta. Jawab chat LLM likhta hai.
Similarity: do vectors kitne paas hain?
Cosine similarity = do vectors ke beech ka angle. Same direction → 1, koi rishta nahi → 0.
Example. Query: "How do I avoid package version clashes between two projects?"
0.593  Conda lets you keep separate Python setups for different projects.   ← top!
0.502  Gradient descent updates model weights to reduce loss.
0.427  Pandas is used to load and clean tabular data.
0.374  Delhi is the capital of India.
0.367  The internship pays 10 lakh per annum after completion.
Query me "conda" word nahi tha, phir bhi Conda sentence top pe aaya. Isse semantic search kehte hain. Keyword search (Ctrl+F) sirf words milata hai, embedding matlab milata hai.
Vectors ko normalize (length = 1) kar do to dot product = cosine similarity. Ek matrix multiplication me saare chunks ka score aa jaata hai.
Score relative hota hai: 0.5 achha hai ya bura, ye fix nahi hai. Ranking dekho, absolute number nahi.
🗺️ Workflow diagram
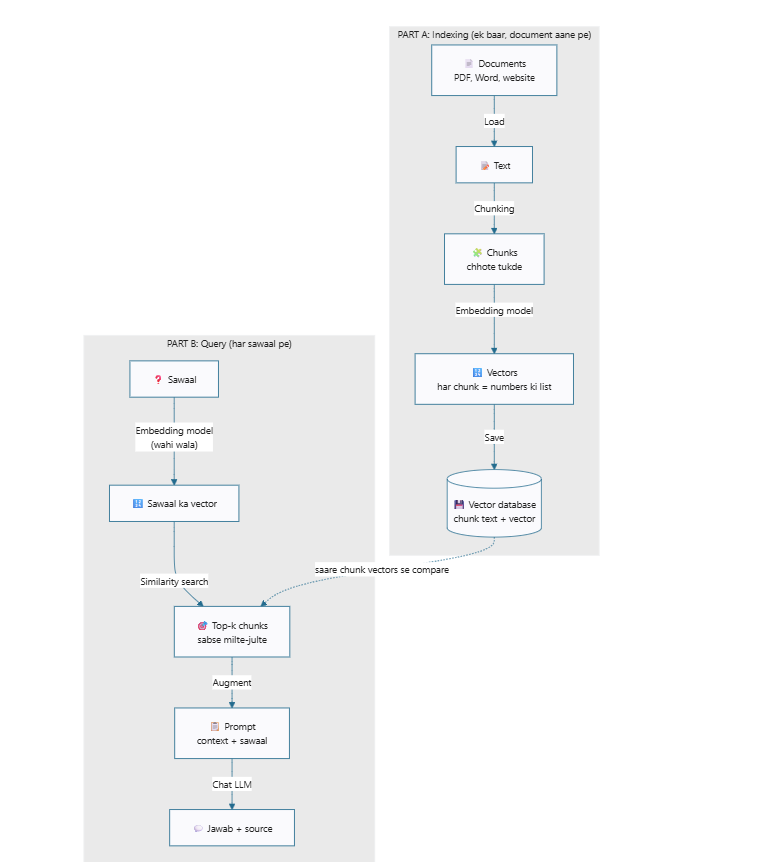
Poora workflow (ek example ke saath)
Maan lo ek company ka HR Policy PDF hai aur employee chatbot se sawaal poochta hai.
PART A: Indexing (document aane pe, sirf ek baar)
① Document                  HR_Policy.pdf (50 pages)
      │  Load (PDF se text nikalo)
      ▼
② Text                      "...Leave Policy: Har employee ko saal me 24 paid
      │                      leaves milti hain. Sick leave alag se 10..."
      │  Chunking
      ▼
③ Chunks (tukde)            Chunk 1: "Leave Policy: Har employee ko saal me 24..." (page 12)
      │                     Chunk 2: "Work from home hafte me 2 din..."          (page 15)
      │                     ... (poore PDF se ~200 chunks)
      │  Embedding model
      ▼
④ Vectors                   Chunk 1 → [0.03, 0.06, -0.16, ... 768 numbers]
      │                     Chunk 2 → [0.01, -0.03, 0.04, ... 768 numbers]
      │  Save
      ▼
⑤ Vector database           har chunk ka text + page number + vector
Ye kaam ek hi baar hota hai. Har sawaal pe document dobara process nahi karte.
PART B: Query (har sawaal pe)
⑥ Sawaal                    "Mujhe saal me kitni chhutti milti hai?"
      │  Embedding model (wahi jo Part A me use kiya)
      ▼
⑦ Sawaal ka vector          [0.04, -0.02, 0.13, ... 768 numbers]
      │  Similarity search → saare chunk vectors se compare
      ▼
⑧ Top-k chunks              Chunk 1 (page 12)  score 0.81  ← sabse milta-julta
      │                     Chunk 7 (page 13)  score 0.64 ...
      │  Augment (prompt banao)
      ▼
⑨ Prompt                    "Sirf is context se jawab do: [chunks] + Sawaal: ..."
      │  Chat LLM
      ▼
⑩ Jawab                     "Aapko saal me 24 paid leaves milti hain [1]"
(Is example ke saare numbers samjhaane ke liye hain.)
Ek line me: Document → Text → Chunks → Vectors → Save ... phir har sawaal pe ... Sawaal → Vector → Milte-julte chunks → LLM → Jawab
⚠️ Zaroori rule: Documents aur sawaal, dono ka vector same embedding model se banana hai. Alag model ke vectors aapas me compare nahi ho sakte.
🧪 Bina RAG vs RAG ke saath
Sawaal: "Mujhe saal me kitni chhutti milti hai?"
Bina RAG: "Ye company pe depend karta hai, aam taur pe 15-20 din..." ❌ (LLM ne tumhari company ki policy kabhi dekhi hi nahi, isliye andaaza lagaya)
⚠️ Embedding model ki language
Kai embedding models sirf English pe train hote hain. Hinglish ya Hindi me wo kamzor hote hain. Ek English embedding model pe test:
Sentences | Similarity |
|---|---|
"conda environment kya hai" vs "Python ka alag virtual setup kaise banaye" | 0.576 |
"conda environment kya hai" vs "Japan ki rajdhani kya hai" | 0.634 ❌ (galat: "kya hai" common hone se zyada mila) |
"What is a conda environment?" vs "How to create an isolated Python setup" | 0.432 ✅ |
"What is a conda environment?" vs "What is the capital of Japan?" | 0.409 |
Isliye documents aur sawaal ki language ke hisaab se embedding model chuno. Hindi/Hinglish ke liye multilingual model chahiye (jaise bge-m3).
🧰 RAG ke popular tools
Kaam | Tools |
|---|---|
Embedding model |
|
Vector database | Chroma, FAISS (local, free), Qdrant, Pinecone (cloud) |
Framework | LangChain, LlamaIndex (poora RAG pipeline ready-made) |
Chat LLM | Koi bhi: Llama, Qwen (Ollama se local), Claude, GPT |
Chhote projects me vector database ki bhi zaroorat nahi. NumPy array me vectors rakh ke similarity nikaal sakte ho. Hazaron-laakhon chunks hon tab vector database chahiye.